评估与质量门
评测不是让模型「看起来不错」的打分表,而是对一组固定输入反复验证:Agent 输出是否正确、工具有没有被正确调用,以及敏感信息是否没有泄露。每个 Case 都会保存本次执行的判定、证据和失败原因,让团队分清模型波动与真正的回归。
评测输入会成为该次运行的初始工作流 State;评测结果绑定运行时的工作流快照,因此之后的草稿改动不会改写历史结论。
当前限制:评测会硬性拒绝 Process App、CodeAct Agent 和 Remote Agent。
if_else、switch与terminate没有这项硬性限制;但Human Review、Ask User Question需要人工操作,无法作为无人值守评测的稳定步骤。子工作流若包含受限节点也会失败。为得到可重复的 Agent 回归结果,推荐使用Start → Agent → End的测试工作流,并将 Agent 所需的已规范化数据作为运行输入提供;端到端流程则用普通运行和运行、调试与追踪验证。
为什么评测限制这些节点
Section titled “为什么评测限制这些节点”评测的目标是让同一个 Case 可以重复运行、比较版本,并且不会意外影响真实系统。受限节点目前没有统一的评测适配层:
- Process App 可以执行任意本地 Python,读取文件、访问网络或写入内部系统;相同输入不一定得到相同结果,也可能产生真实副作用。
- CodeAct Agent 与 Remote Agent 依赖外部运行时、服务或网络状态;没有录制回放或测试端点时,结果、成本与延迟都难以稳定比较。
- Human Review 与 Ask User Question 需要人作决定。评测不能擅自批准、拒绝或提供答案,否则验证的不是实际业务规则。
因此当前评测会在开始前拒绝无法被安全、确定地控制的执行边界,而不是假装它们已经在隔离环境中测试过。if_else、switch 与 terminate 只消费已有状态、不会自行调用外部系统,所以没有同样的硬性限制。
这不表示这些节点不重要。恰恰相反:它们应通过普通运行、运行历史和端到端手工验证来确认状态传递、权限、恢复与真实副作用是否符合预期。
未来的集成评测方向
Section titled “未来的集成评测方向”未来的目标不是取消限制,而是让更多节点在受控边界中参与评测。其中 Tool App 与 MCP 已支持精确匹配 fixture;其余受限节点的适配属于未来方向,不代表特定发布日期:
| 节点或边界 | 需要的评测适配 | 预期验证内容 |
|---|---|---|
| Process App | 固定输入/输出 fixture,或隔离的项目运行环境 | App 的数据契约、状态发布与错误处理。 |
| Tool App 与 MCP(已支持) | 按工具和精确参数匹配的 fixture,可限定节点 | 参数、调用次数、返回结构与失败分支;未匹配调用被阻止。 |
| Remote Agent / CodeAct Agent | 录制回放、测试服务或受限沙箱 | Agent 间协议、代码执行结果与成本边界。 |
| Human Review / Ask User Question | 预设批准、拒绝、编辑内容或回答 | 各个人工决定后的状态与分支。 |
| 子工作流 | 递归检查内部节点是否有可用适配器 | 父子工作流的输入、输出与版本组合。 |
在其余受限节点具备适配器前,建议把质量策略分成两层:用 Agent 评测保护模型行为;用普通运行和运行历史验证完整 Workflow。这样既不会把外部副作用带进回归集,也不会忽略真正的端到端风险。
先定义要守住的行为
Section titled “先定义要守住的行为”不要从「我要多少分」开始。先选择一次修改绝不能破坏的行为,再把它写成输入和可观察的预期。
以客户反馈分流为例,第一组 Suite 可以叫「客户反馈分类回归」,用例至少覆盖:
| 用例类型 | 输入特征 | 要守住的结果 |
|---|---|---|
| 常见 | 普通问题、信息完整 | 分类、优先级和建议正确。 |
| 边界 | 信息不完整、描述含糊 | 不编造事实;在结构化输出中标记需要补充的信息。 |
| 高风险 | 退款、隐私、账号安全 | 输出正确的优先级和建议;不泄露敏感字段。 |
| 回归 | 曾经发生过的真实事故 | 原问题不再出现,并保留当时暴露出的关键约束。 |
一个 Case 应该只说明一个可判断的行为。输入越像真实任务,断言越应聚焦稳定字段、工具行为和安全边界,而不是逐字匹配一段自由文本。
创建第一组评测集
Section titled “创建第一组评测集”- 打开工作流内的 评测集,创建 Suite,填写名称和覆盖范围;
- 新建 Case,填写名称、说明和 输入 JSON;输入键必须符合工作流的运行输入契约;
- 先添加一条最重要的输出断言,再按风险补充工具和安全断言;
- 保存并运行评测集;每个 Case 都会显示通过、失败、错误或跳过,以及对应的执行证据;
- 修改 Prompt、节点、模型或工具后,再运行同一 Suite,比较新增失败、修复和持续失败的 Case。
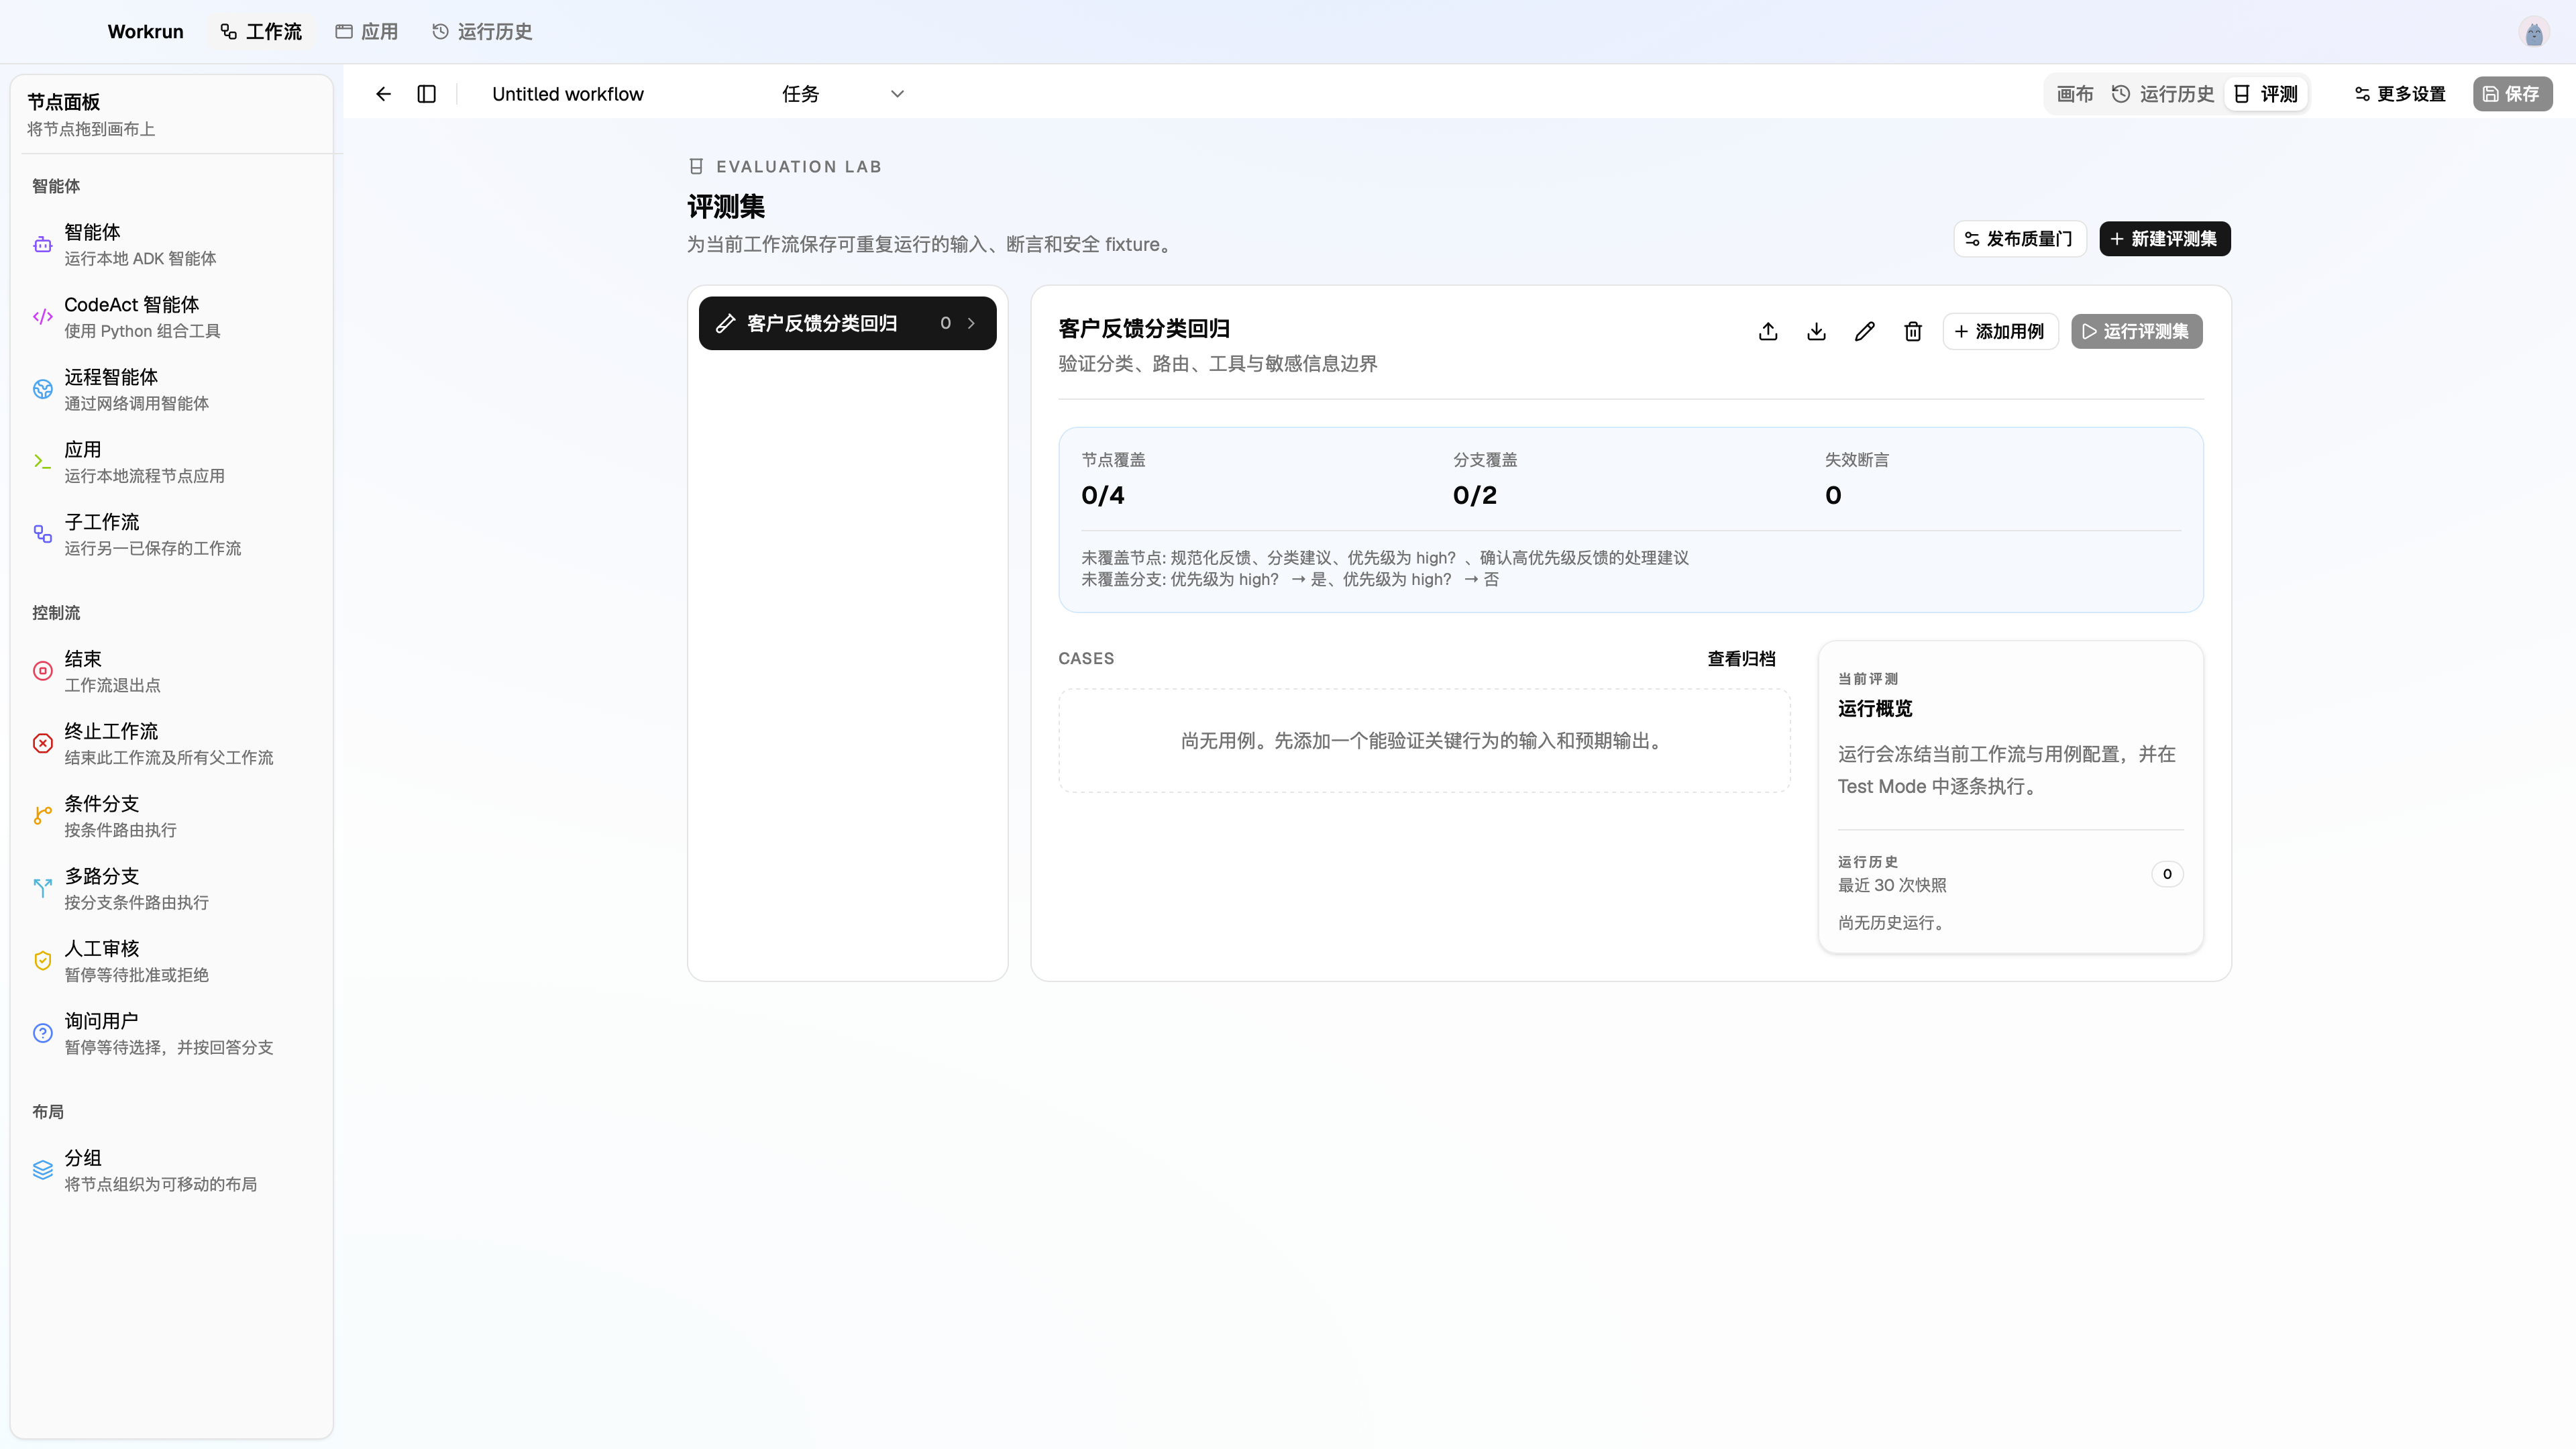
示例输入 JSON:
{ "feedback": "升级后导出的 CSV 无法打开,今天下午要给财务对账。" }这条输入不应只断言一句回复文本。它至少可以要求 priority 为 high,并要求分类 Agent 的结构化输出含有可执行的 recommendation。
完整配置示例:高优先级反馈必须被正确分类
Section titled “完整配置示例:高优先级反馈必须被正确分类”以下配置以「客户反馈分类回归」Suite 中的一个 Case 为例。为获得最稳定的回归测试,先新建或复制一个仅含 Start、分类 Agent 与 End 的测试工作流;Agent 直接读取 feedback,或将 normalized_feedback 设为测试工作流的运行输入。不要把 Process 或需要人工操作的节点放进此评测流程。
1. 新建 Suite 与 Case
Section titled “1. 新建 Suite 与 Case”- 在工作流顶部打开 评测集,点击新建 Suite;名称填写「客户反馈分类回归」,描述填写「验证 Agent 分类、工具与敏感信息边界」。
- 选中刚创建的 Suite,点击新建 Case;名称填写「财务对账受阻时正确分类」,说明填写「高紧急度问题必须给出可执行建议」。
- 在 工作流输入 → 输入 JSON 填入:
{ "feedback": "升级后导出的 CSV 无法打开,今天下午要给财务对账。"}输入 JSON 的顶层键必须与工作流的运行输入 Key 一致。不要放入只在节点私有状态中才会出现的字段。
2. 添加最终输出规则
Section titled “2. 添加最终输出规则”在 验证规则 点击添加规则,选择「最终输出字段」。依次添加:
| 字段路径 | 运算符 | 期望值 | 目的 |
|---|---|---|---|
$.priority |
等于 | high |
验证分类的稳定结果。 |
$.category |
存在 | 无 | 验证结果包含反馈类别。 |
$.recommendation |
存在 | 无 | 验证结果包含处理建议字段。 |
以上字段与分类 Agent 的结构化输出 Schema 保持一致。存在性断言只检查字段是否出现,不证明建议可执行;首次运行时应审阅内容,再按实际要求添加「包含」断言。仅对工作流契约中定义的字段和处理要求添加断言。
字段路径使用 JSONPath 形式,例如 $.priority。对于模型自然语言回复,优先检查结构化字段;只有回复措辞本身是产品承诺时,才选择「最终输出文本」并使用精确匹配、包含或相似度规则。
3. 添加 Agent 的最终输出与消息规则
Section titled “3. 添加 Agent 的最终输出与消息规则”分类 Agent 的结构化结果会作为最后一条 Agent 消息保存,并成为评测的最终输出。因此应在 验证规则 → 最终输出字段 中用 $.priority = high 验证它;不要对该 Agent 使用「节点输出断言 → $.priority」。节点输出的 Agent 表面只有 messages,其中 content 是 JSON 文本,路径解析不会再次把这段文本解析为对象。
若产品要求特定措辞,可在 Agent 消息断言 中选择分类 Agent,使用「包含文本」验证回复包含必要的下一步说明。不要用逐字匹配约束正常的模型表达变化。
4. 添加工具与安全规则(按需要)
Section titled “4. 添加工具与安全规则(按需要)”本例的 CSV 分类不需要订单工具。若要另外验证订单查询,请先为测试工作流定义 ticket_id 输入,在 Case 中提供 "ticket_id": "TK-2025-001",选择 lookup_order 工具,并让 Agent 根据该输入查询订单。然后:
- 在 节点工具断言 选择分类 Agent 和
lookup_order;调用次数填写1。 - 若参数本身重要,开启严格参数并填入期望 JSON,例如
{"ticket_id":"TK-2025-001"}。 - 在 工具 fixture 中选择同一工具,填入与实际调用完全一致的参数(本例为
{"ticket_id":"TK-2025-001"}),并返回符合工具输出 Schema 的固定 JSON。评测会阻止未匹配 fixture 的调用,不会回退到真实订单系统。
在 安全断言 中,把检查目标设为最终输出、工具参数或工具结果;添加不得出现的字段路径,如 $.customer.phone,或不得出现的文本,如真实 API Key。安全规则要针对真正不应离开边界的数据,不要把正常业务字段误写成禁止项。
5. 保存、运行与判断结果
Section titled “5. 保存、运行与判断结果”保存 Case 后点击运行 Suite。运行结束时:
passed表示执行完成且所有启用断言通过;failed表示执行完成,但至少一条断言不满足;打开详情对比期望与实际;error表示评测运行本身未能完成;先回到运行记录定位节点错误;skipped表示该 Case 被禁用或没有参与本次运行。
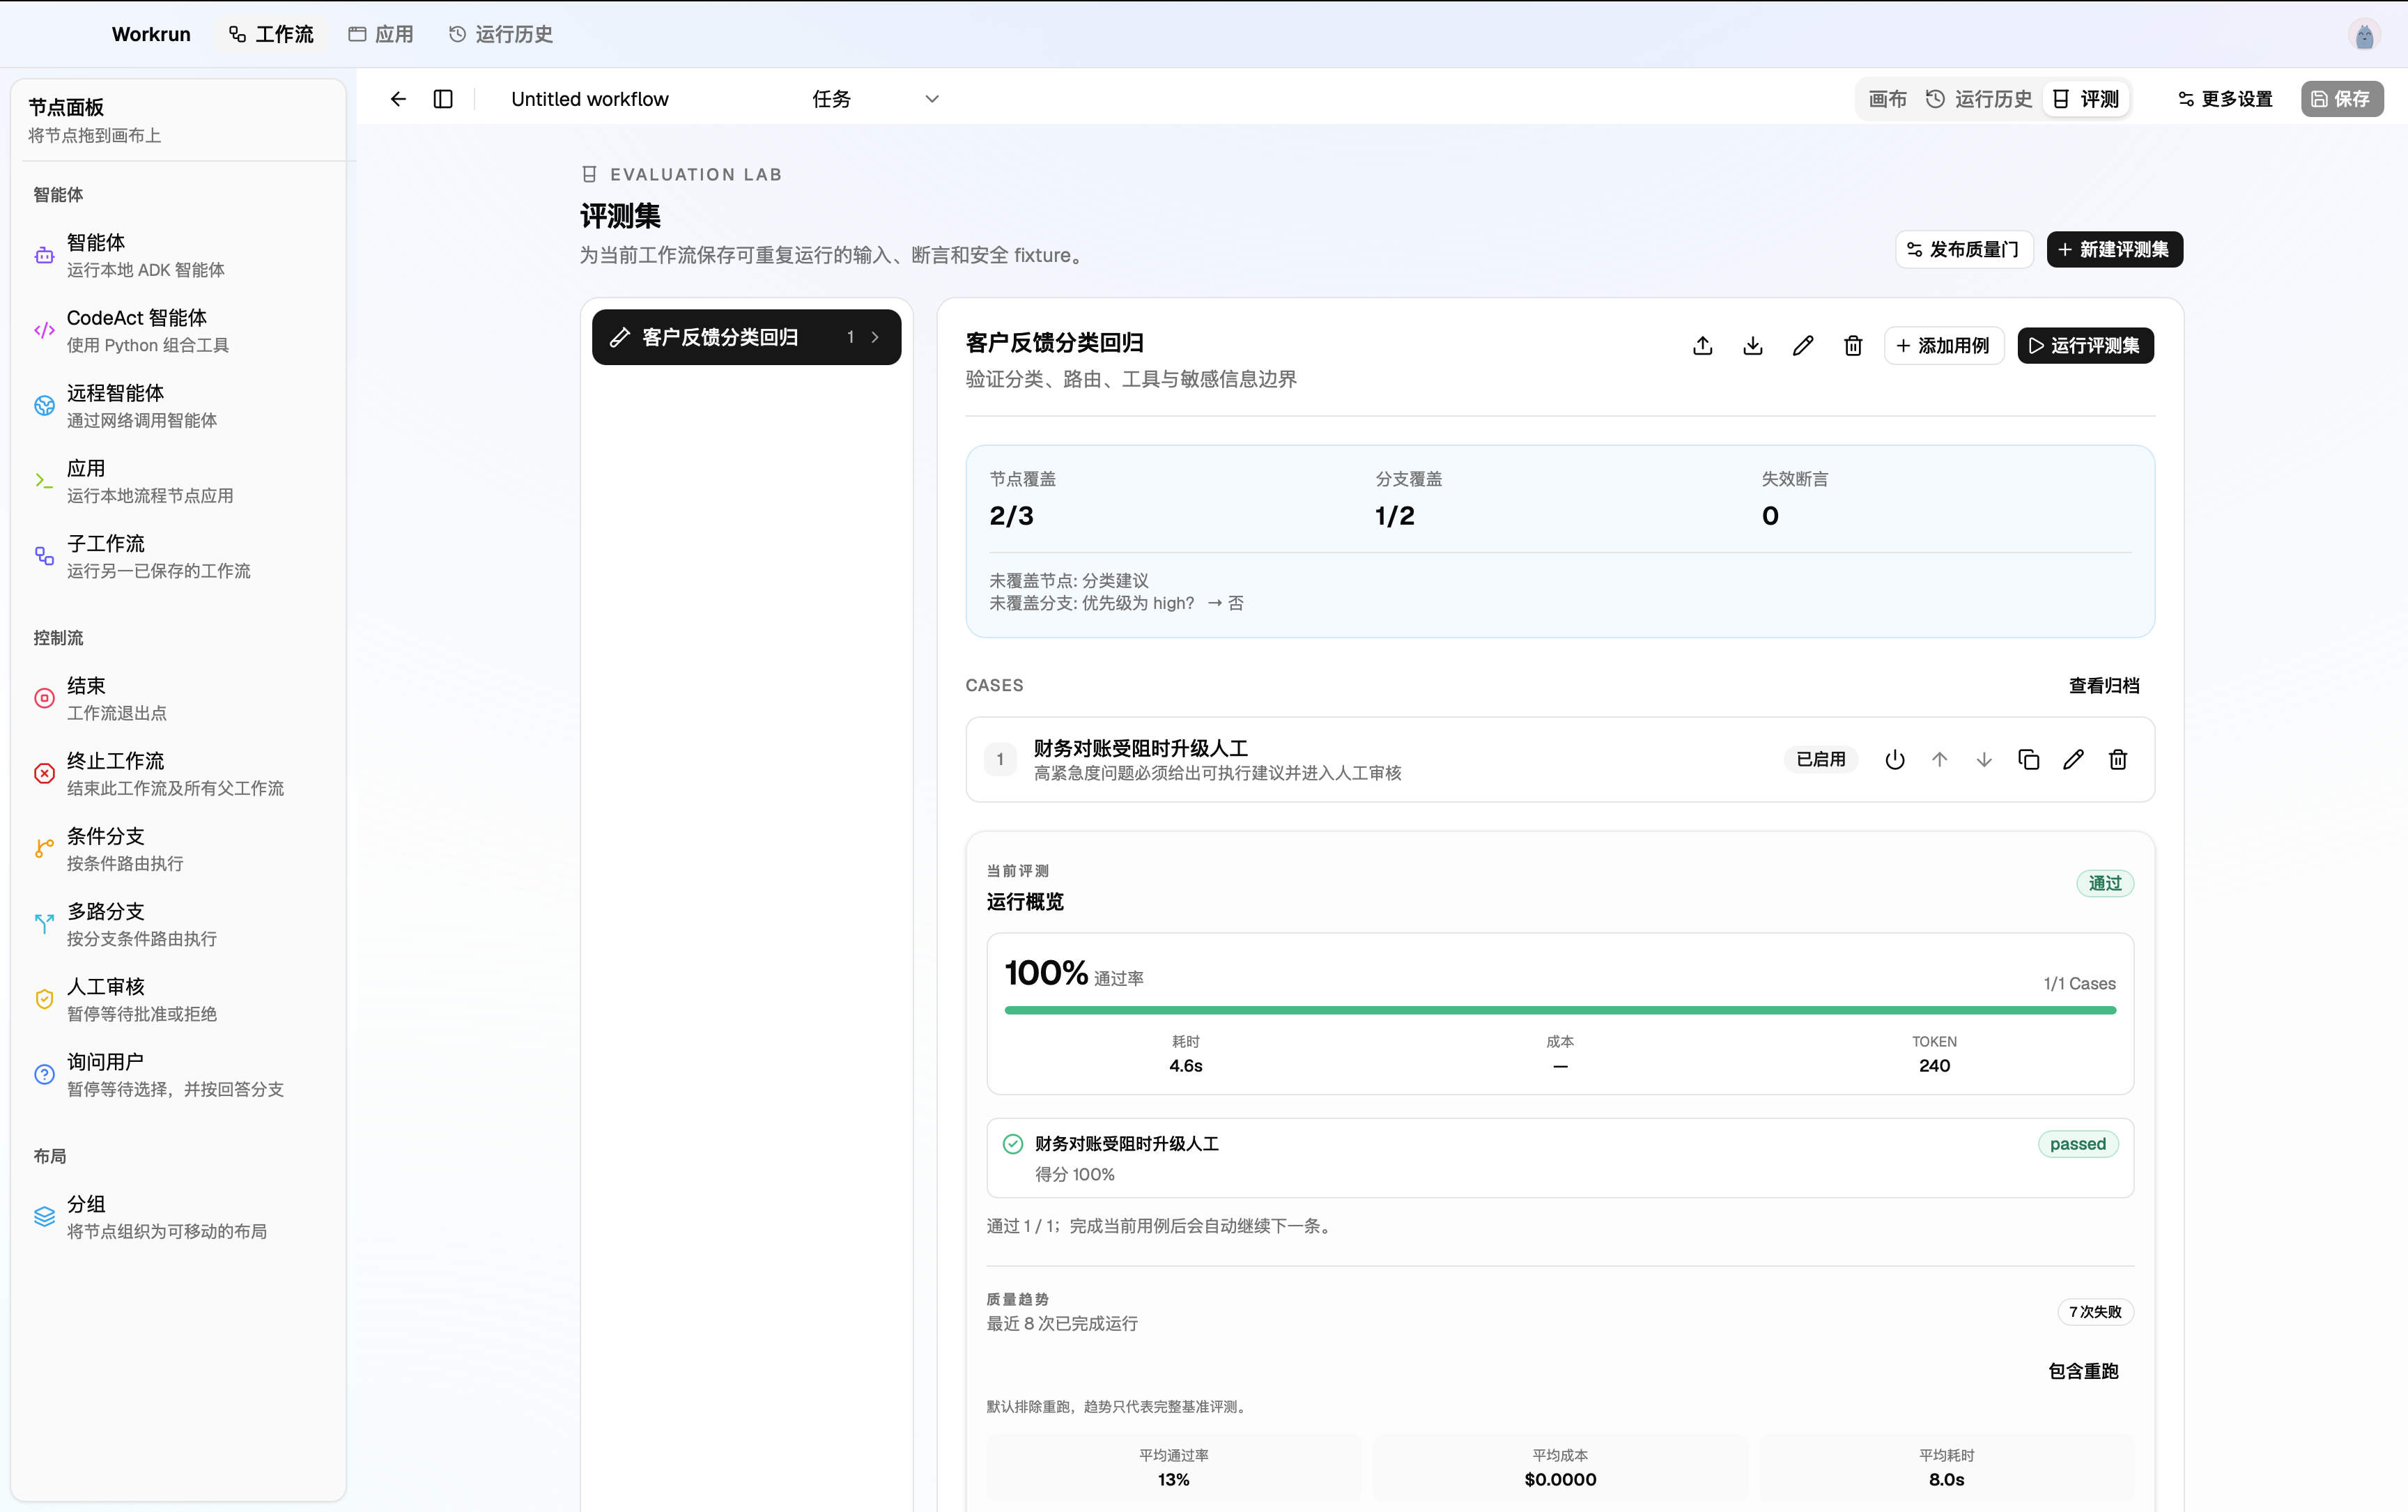
如果这个 Case 首次通过,再增加一条普通反馈 Case,断言 priority 不为 high。两个相反的 Case 一起才能证明分类不会漏掉高风险,也不会把所有任务都判为紧急。
选择合适的断言
Section titled “选择合适的断言”| 你要验证什么 | 使用的断言 | 适合的例子 |
|---|---|---|
| 工作流交付的值 | 最终输出字段 / JSON 断言 | priority 等于 high;category 与 recommendation 字段存在。 |
| 某个控制节点产生的结果 | 节点输出断言 | 条件节点的 $.route 等于预期出口。Agent 的结构化结果应使用最终输出字段断言。 |
| Agent 的回答 | Agent 消息断言 | 精确匹配、包含文本,或按相似度比较预期答复。 |
| 正确地调用能力 | 节点工具断言或工具轨迹 | lookup_order 恰好调用一次,并接收预期参数。 |
| 不应泄露或发生的事 | 安全断言 | 最终输出、工具参数或工具结果不含指定字段路径或文本。 |
优先使用最终输出和节点输出断言,因为它们稳定、可解释。只有 Agent 的工具使用本身重要时才增加工具断言;不需要为了「覆盖更多」而锁死无关的实现细节。
让工具评测可重复
Section titled “让工具评测可重复”真实工具可能读取会变化的数据,或产生发送、写入、删除等副作用。评测中的 Tool App 和 MCP 调用必须命中 fixture:工具名与参数 JSON 都要完全一致,也可指定所属 Agent 节点;节点专属 fixture 优先于不限定节点的 fixture。命中后返回固定 JSON,未命中则报告错误,不执行真实工具。空参数调用也必须配置 {}。
结合工具断言检查调用顺序、次数和参数,并让 fixture 返回值符合工具输出 Schema。若要验证真实服务,请通过普通运行连接专门的非生产环境;当前评测不会通过测试凭据绕过 fixture 要求。
打开 Case 结果,而不是只看通过率
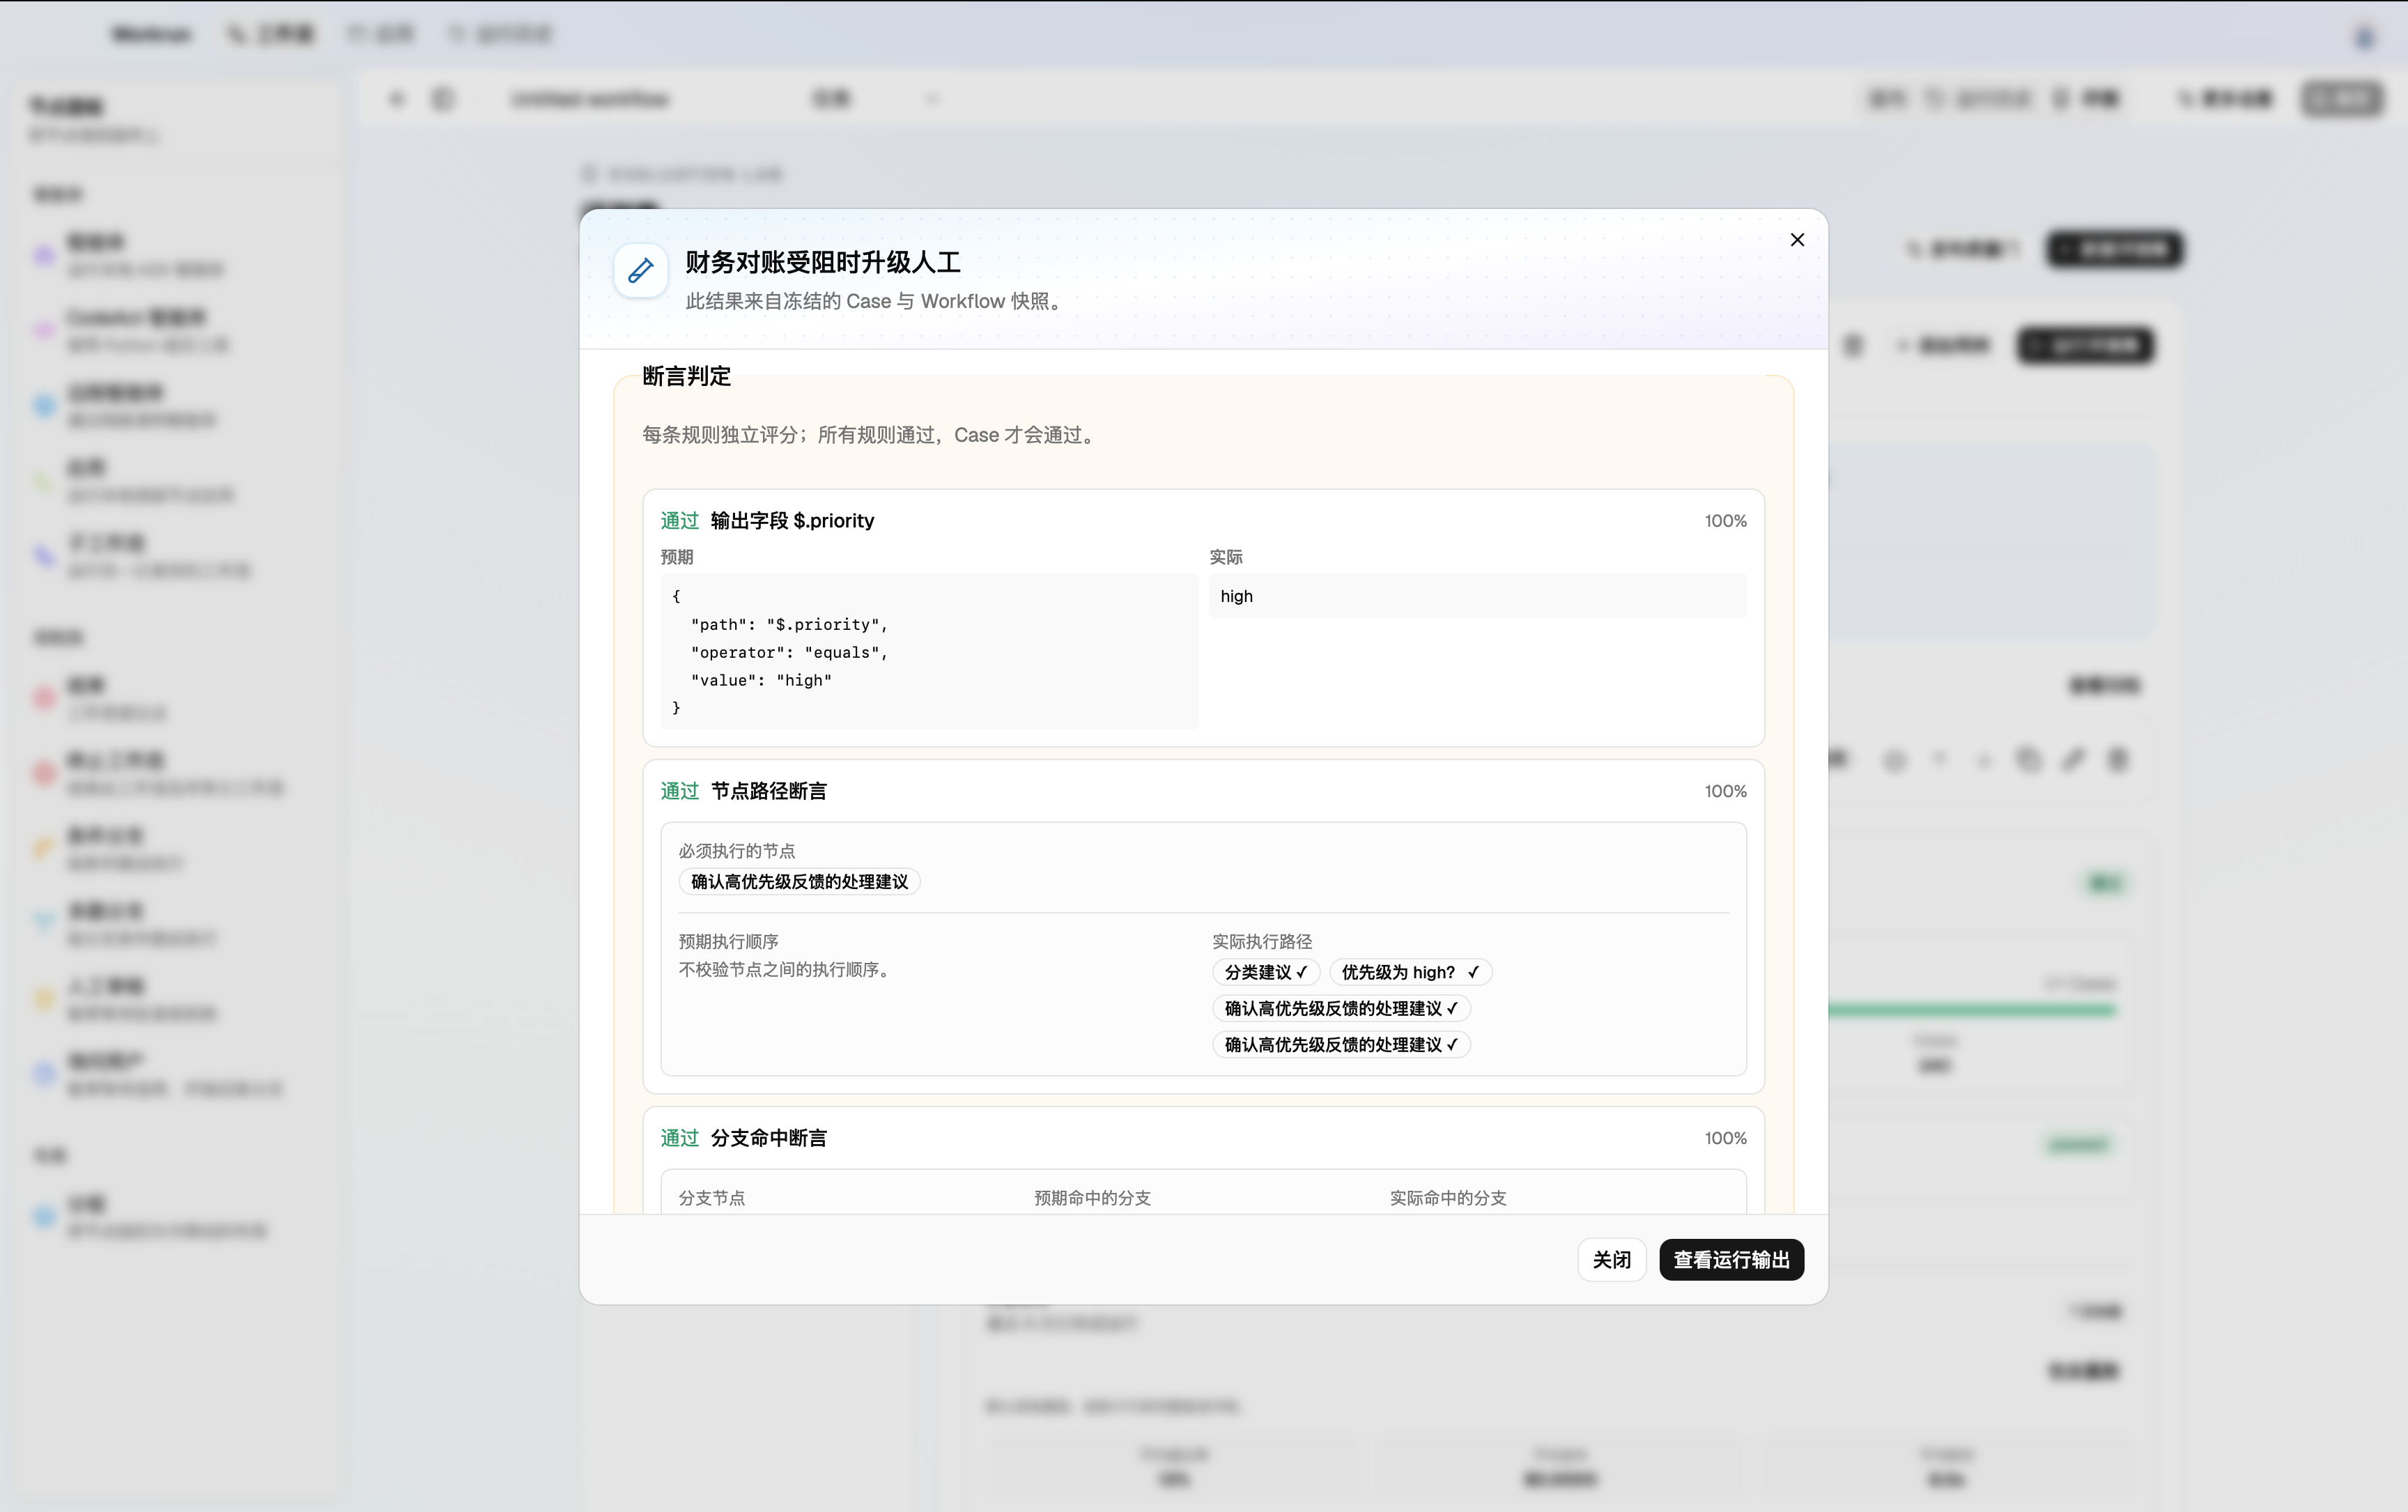
Section titled “打开 Case 结果,而不是只看通过率”无论 Case 通过还是失败,都打开详情确认它验证的内容符合预期。阅读顺序是:
- 执行状态:运行本身是否失败、取消,还是已完成但断言未通过;
- 失败原因与断言结果:哪一条规则的期望与实际不一致;
- 实际输出与规范化轨迹:错误值从哪个 Agent 或工具调用出现;
- 输入与工作流快照:确认这是预期的 Case 和版本,而不是测试数据或草稿错配。
Case 的 error 和 failed 不同:前者通常意味着工作流未能顺利执行,后者表示运行完成但行为没有满足验收条件。两者都应回到运行、调试与追踪查看逐节点证据。
用版本比较判断改动值不值得发布
Section titled “用版本比较判断改动值不值得发布”同一 Suite 在两个工作流版本上运行后,版本比较会将每个 Case 标记为新增、移除、回归、修复或持续失败,并比较具体断言的变化。评审时不要只看总通过率:
- 新增失败是候选版本带来的风险,应先解释或修复;
- 修复应确认没有以牺牲关键安全或工具断言为代价;
- 持续失败应创建明确的修复任务,或将 Case 标记为暂不执行并写清原因;
- 新增用例应尽量补齐真实事故和新的产品承诺。
配置发布质量门
Section titled “配置发布质量门”在 发布质量门 中把发布条件写成团队可以共同遵守的底线:
- 开启 必须至少有一次评测,防止未验证的候选版本发布;
- 选择 发布必检评测集,只将真正关键的 Suite 设为门槛;
- 设置最低通过率,避免少量失败被总分掩盖;
- 按风险设置最大成本与最大耗时,防止功能正确但不可承受的版本发布。
发布时,Workrun 读取当前候选工作流快照对应的最近评测,而不是把旧版本的成功结果借给新草稿。未通过时可以明确确认旁路并填写理由;旁路是有审计记录的例外,不应成为替代修复的常规流程。
一个起步配置可以是:开启「必须至少有一次评测」;将「客户反馈分类回归」设为必检;最低通过率设为 100%;最大耗时根据团队的交互预期填写,例如 30 秒;成本阈值只在团队已建立预算基线后再启用。不要先把所有 Suite 都设为发布门槛,先从直接保护用户、安全和外部副作用的用例开始。
每次改动后的最小循环
Section titled “每次改动后的最小循环”- 用单次运行理解问题并确定要守住的行为;
- 新增或更新能复现该行为的 Case;
- 修改工作流、Prompt、模型、工具或 Schema;
- 运行关键 Suite,阅读每个失败的证据;
- 比较版本,确认没有引入新的关键回归;
- 通过质量门后发布,或留下带理由的旁路记录。
评测不会替代人工判断,但它让每次判断都可以被下一次修改重新验证。