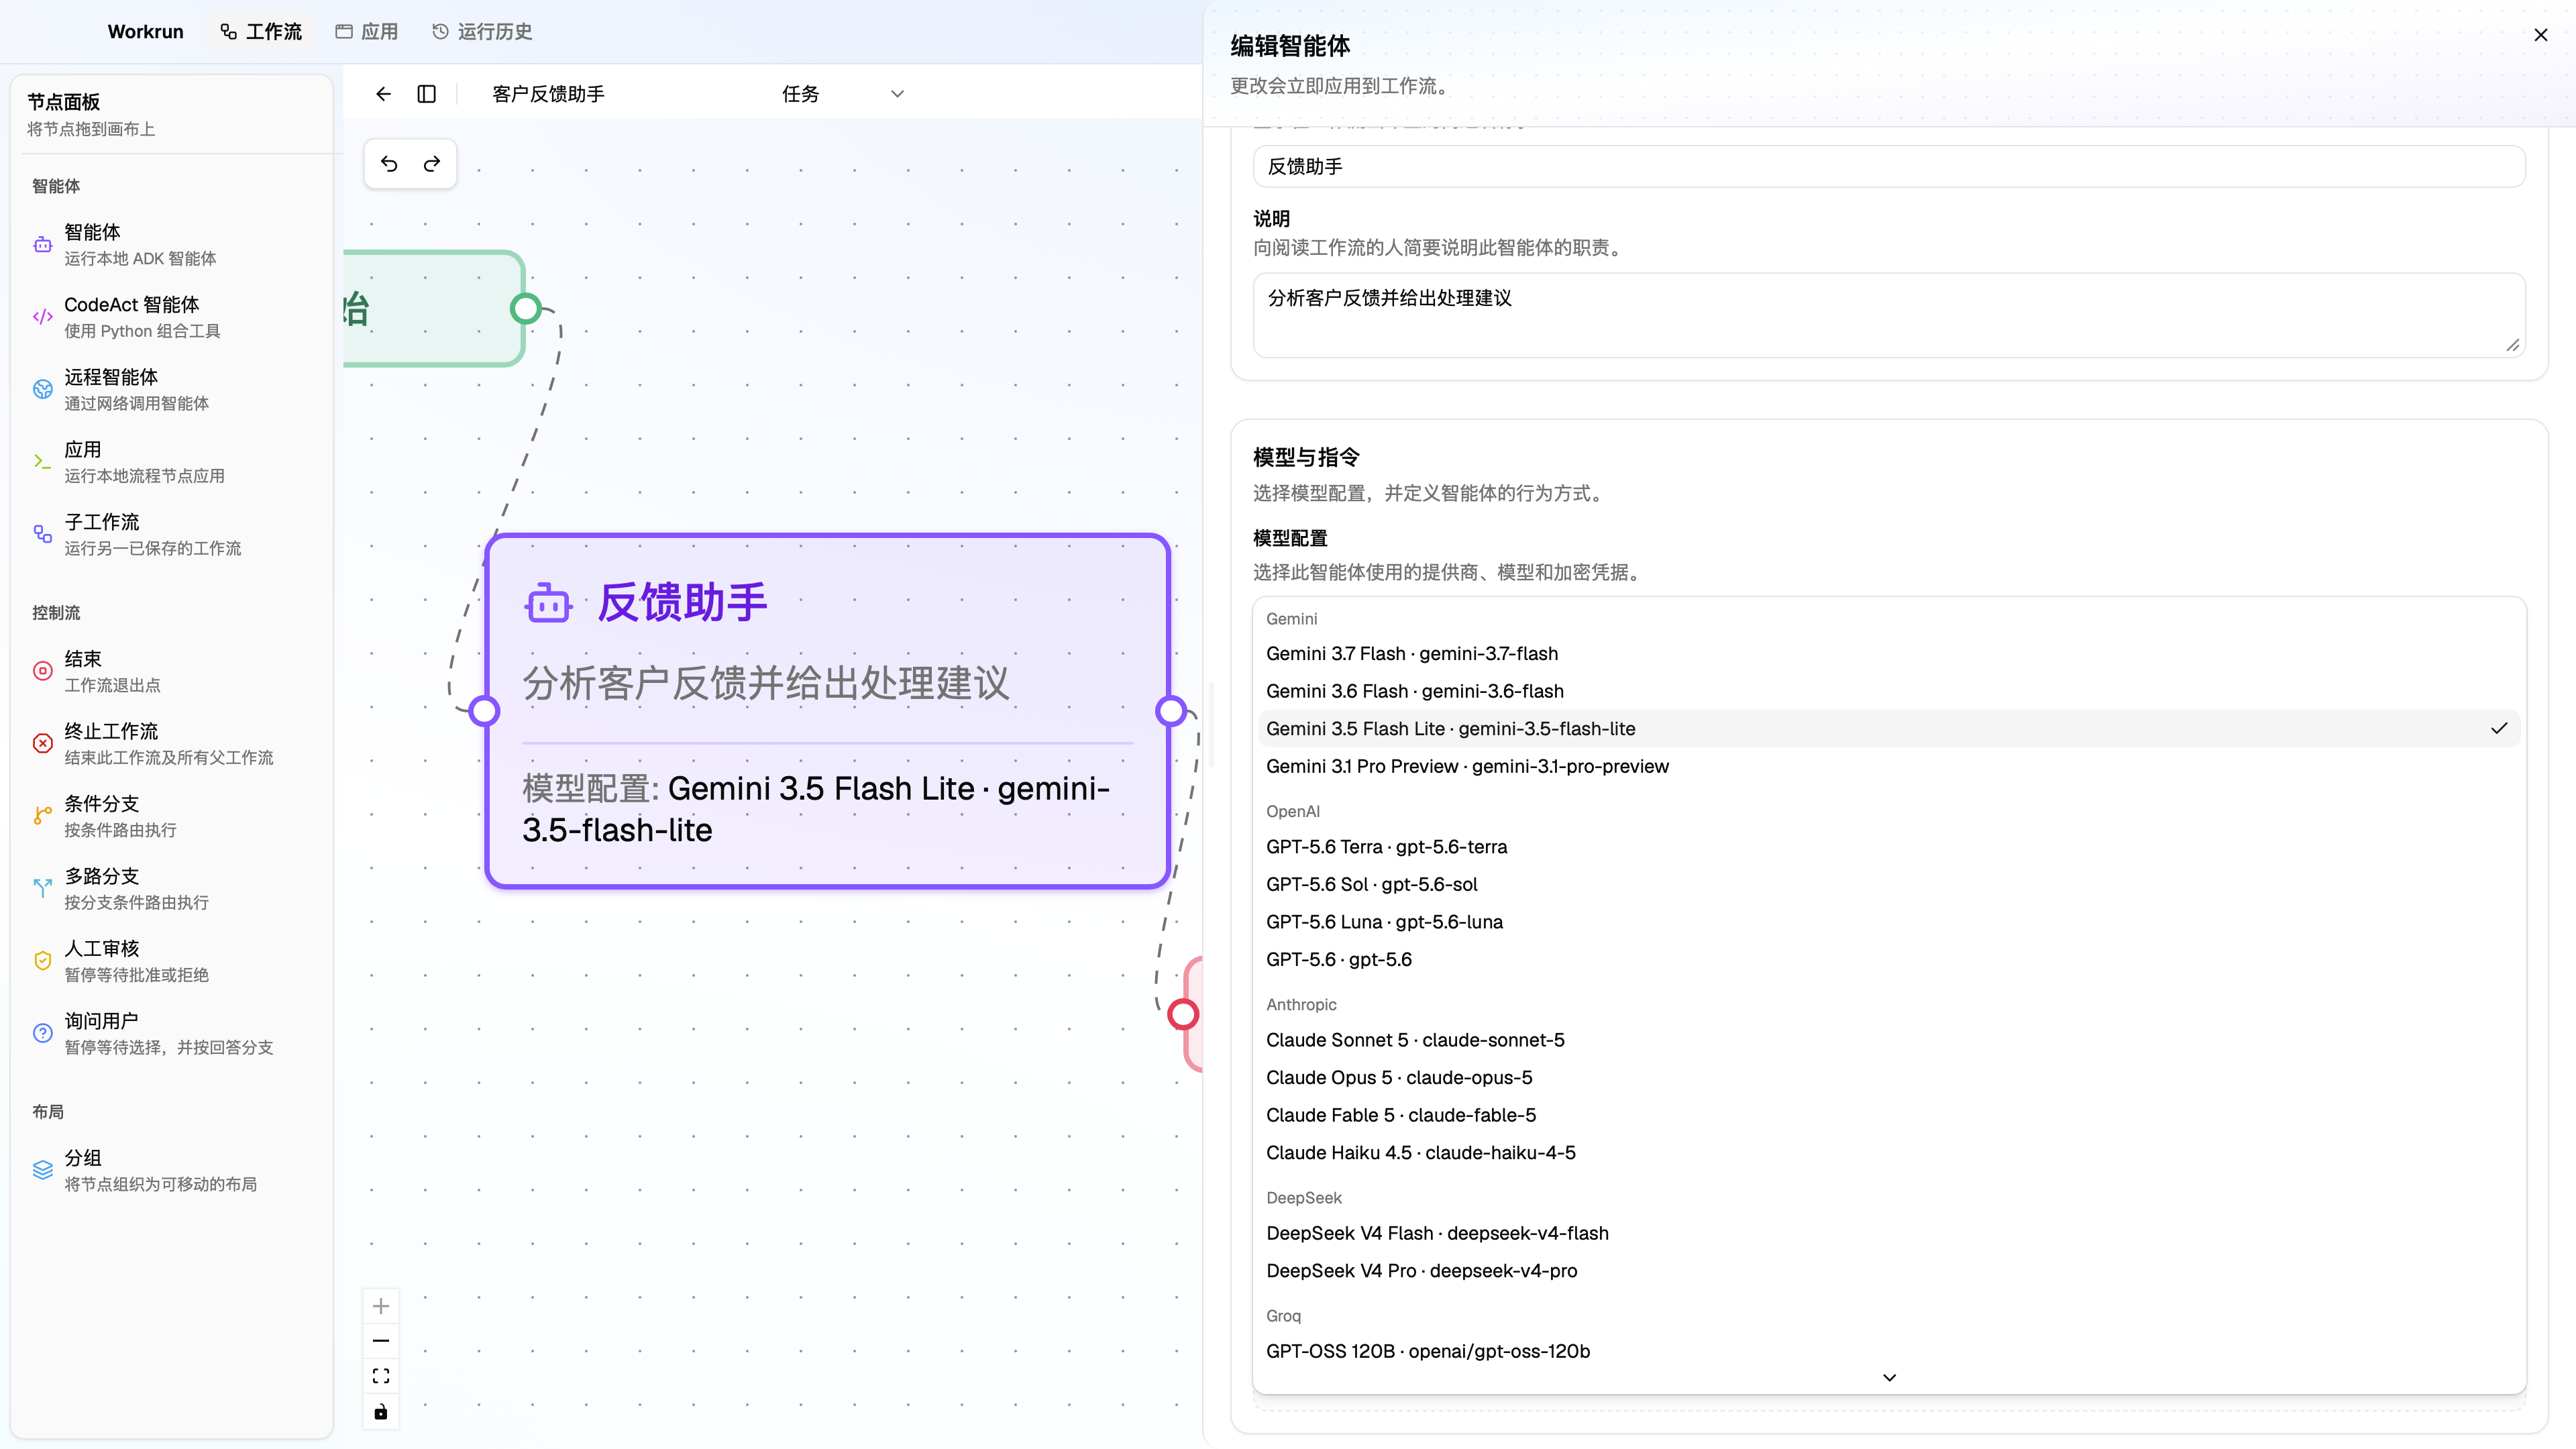
配置模型访问
也可以在开始页描述目标,让助手先提出方案,确认后生成可编辑工作流。详见通过对话编排工作流。方案确认与执行确认相互独立。
模型选择器包含内置 Provider 模型;团队模式登录后还会合并 Server 模型目录。首页助手、Agent 和 CodeAct Agent 都使用同一套模型访问机制,无需为每个工作流重复填写模型 ID。
添加 Provider 凭据
Section titled “添加 Provider 凭据”- 打开 设置 → 模型;
- 在要使用的 Provider 一行填写 API 密钥;
- 设置自动保存;
- 新建或编辑 Agent,在其 模型配置 中选择该 Provider 的内置模型。
Ollama 使用端点配置而非 API 密钥;本地默认端点通常即可使用,远程部署时填写相应地址。
团队模型:Workrun Server → LiteLLM
Section titled “团队模型:Workrun Server → LiteLLM”- 在 设置 → 工作区 连接团队 Server 并登录。
- 在首页或节点模型选择器中选择 Server 来源的模型 alias;目录由 Server 从 LiteLLM 自动读取。
- 在该模型支持的范围内选择 Chat Completions 或 Responses,以及已报告的推理强度。默认推理档位不发送额外参数。
桌面端使用当前已验证的 Workrun 会话,不需要填写 LiteLLM Key。管理员将 Team Virtual Key 配置在 Server,Provider 凭据由 LiteLLM 管理。一个 Server 对应一个 LiteLLM Team,当前有效登录用户共享其模型权限。
模型的工具、图片、结构化输出、协议和推理档位由网关能力信息提供;未知时不猜测能力。模型 alias 必须与该 Team Key 可见的目录一致。Responses 使用客户端重放历史,Server 强制 store: false。
团队模式仍可以显式选择本机 Provider 直连。直连请求不经过 Server/LiteLLM,使用本机凭据;Server 模型失败不会自动切换为直连。切换账号或退出会中断团队模型流。后台任务恢复也需要原用户的有效会话,不能仅靠保存的任务跨账号执行。
部署说明见部署 Server、LiteLLM 与 Langfuse。升级旧工作流时,原来的个人模型不会自动映射为团队 alias;请显式重新选择、保存,必要时发布新版本。
- 一个 Provider 的密钥可供该 Provider 下的内置模型使用;
- 不要将密钥放入节点指令、工作流输入或 Python 代码;
- Agent 的名称、职责、指令、工具和生成参数仍在节点检查器中配置;
- 切换模型后,用同一组输入重新运行工作流,确认结果符合预期。